Appearance
AiChat AI 对话助手
全局 AI 对话面板:顶栏 ✨ 图标或 Ctrl + I 唤起,多会话 + 分组管理(新建 / 切换 / 重命名 / 删除 / 按分组归类),流式回复、附件随消息发送、模型切换、历史按登录人持久化,支持全屏与拖动调整输入框高度。
默认不依赖任何后端。 传输层默认是浏览器内的模拟实现(打字机式吐字),所以静态部署也能完整演示;接真实模型只需在启动时换一个 transport,界面代码一行不用改。
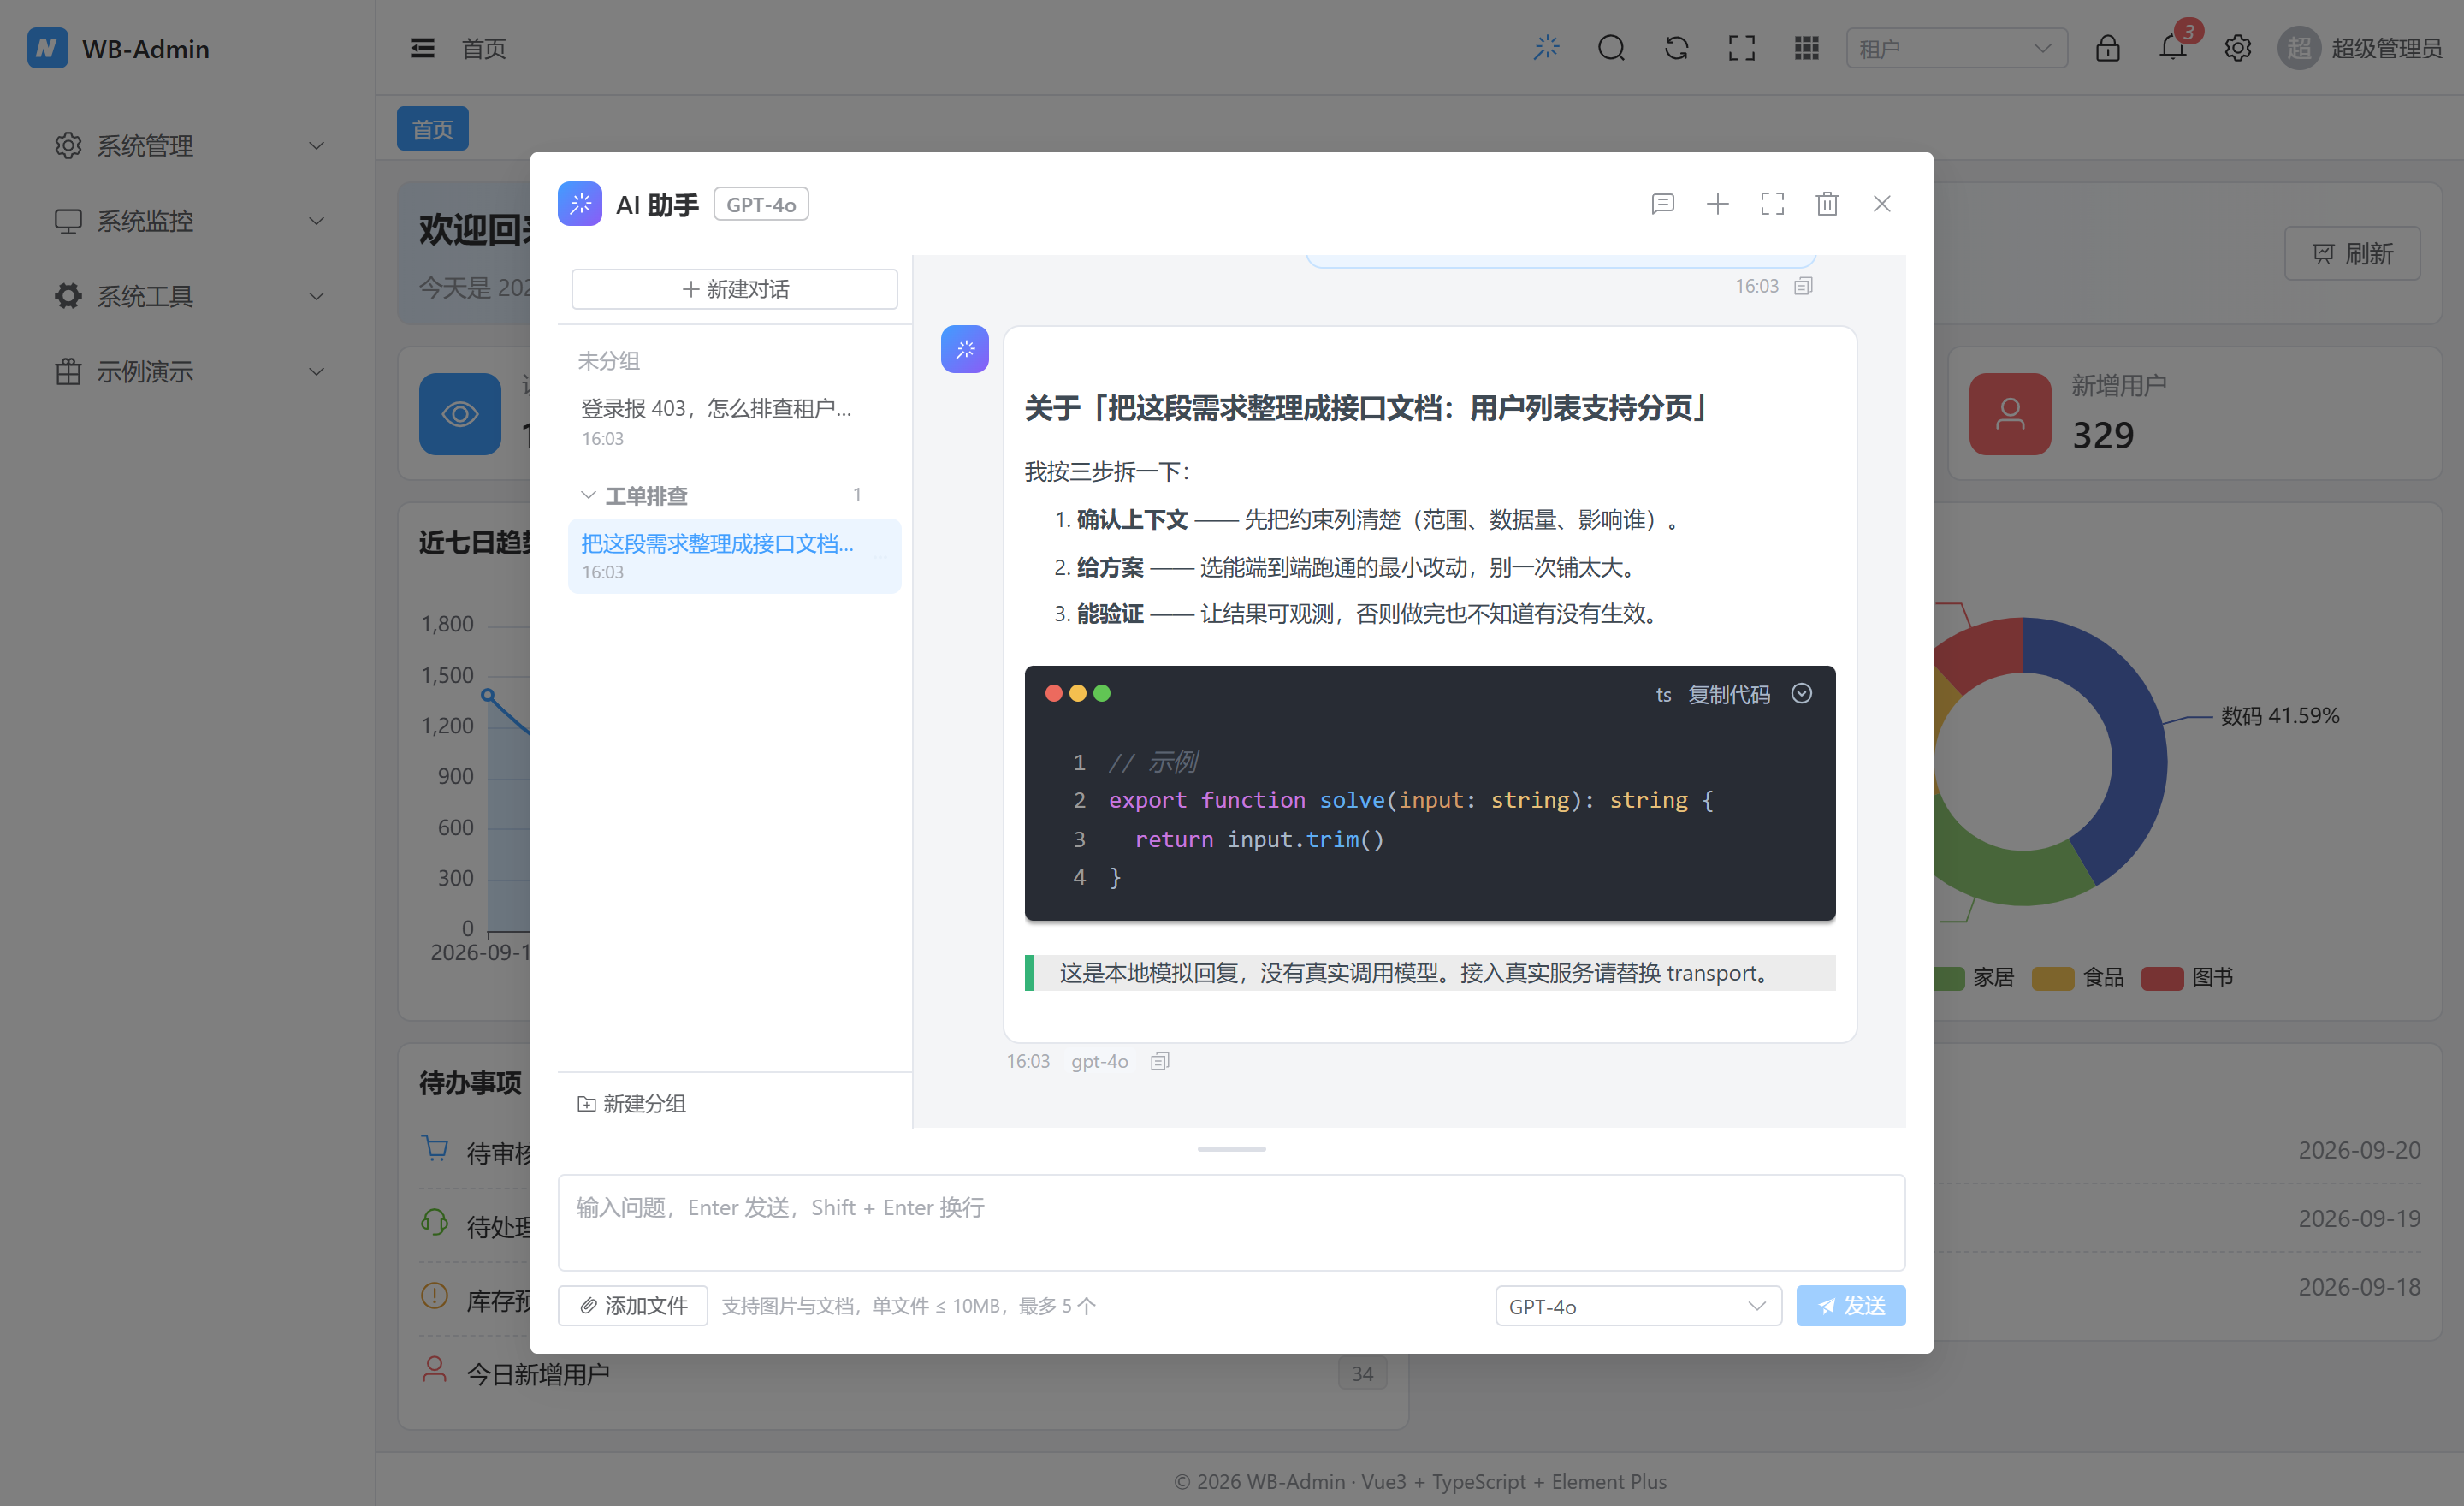
本页给两类人看:
- 前端:从零复刻这个面板,或把它接到自己的项目里;
- 后端:需要提供哪两个接口、字段长什么样、SSE 怎么吐、有哪些服务端职责不能省。
目录与职责
| 文件 | 职责 |
|---|---|
src/components/AiChat/transport.ts | 传输层:AiChatTransport 接口、本地模拟实现、HTTP/SSE 实现、全局装配点 configureAiTransport() |
src/components/AiChat/useAiChat.ts | 全局会话状态(模块级单例):会话与分组、发送 / 停止 / 清空 / 附件校验 / 历史持久化 |
src/components/AiChat/index.vue | 弹窗 UI:会话侧栏、消息列表、Markdown 渲染、附件区、模型选择、拖动条 |
src/layouts/components/Navbar/index.vue | 顶栏入口图标 |
src/layouts/index.vue | 挂载弹窗 + Ctrl + I 快捷键 |
src/types/index.ts | AiModel / ChatMessage / ChatAttachment / ChatGroup / ChatSession / AiChatRequest / AiChatHandlers / AiChatTransport |
src/mock/index.ts | GET /ai/models、POST /ai/chat 的联调占位实现 |
test/unit/ai-chat.spec.ts | 传输层解析、流式拼装、abort、附件限额、历史隔离、会话分组与 v1 迁移 |
test/e2e/ai-chat.spec.ts | 真实浏览器交互回归(含新建对话、建组、移动、折叠、刷新保持) |
数据流
点击发送
  └─ useAiChat.send()
       ├─ 固定当前会话 id(sid)—— 之后所有写入都认这个 id,不认「当前会话」
       ├─ 先取历史(必须在推入本条之前取,否则最后一条会重复发)
       ├─ 本地插入 user 消息 → 清空输入框与待发附件 → 首条消息顺便生成标题
       ├─ 插入 assistant 占位消息(pending: true)
       └─ transport.chat(req, { onDelta })
            ├─ onDelta(chunk) → 追加到 sid 的占位消息 → 界面增量渲染
            ├─ resolve        → pending = false
            └─ throw          → error = true + composer 上方错误条
界面只认 AiChatTransport 这个接口,不知道底下是模拟还是 HTTP/SSE。这是整个设计的支点:换后端、换网关、换厂商 SDK,都只动 transport。
一、前端实现步骤
1. 先定类型
ts
export type ChatRole = 'user' | 'assistant'

export interface AiModel {
  id: string
  name: string
  provider?: string   // 下拉里做副标题
  context?: number    // 上下文窗口(token)
  desc?: string
  disabled?: boolean  // 下线但不删,避免历史里选过的模型彻底消失
}

export interface ChatAttachment {
  uid: string         // 本地唯一 id,列表 key 与移除用
  name: string
  size: number
  type: string        // MIME,图标展示用
  file?: File         // 只在内存里,绝不落盘
  url?: string        // 走真实后端时回填
}

export interface ChatMessage {
  id: string
  role: ChatRole
  content: string
  model?: string
  attachments?: ChatAttachment[]
  time: number
  pending?: boolean   // 流式输出中
  error?: boolean     // 本条生成失败
}

/** 会话分组。未分组不是一条记录,用 groupId: '' 表示 */
export interface ChatGroup {
  id: string
  name: string
  collapsed?: boolean  // 折叠状态也持久化
  createdAt: number
}

/** 一个独立会话,各自持有消息、模型与归属分组 */
export interface ChatSession {
  id: string
  title: string        // 首条消息截断生成,也可手动改名;空串 = 新对话
  groupId: string      // '' = 未分组
  messages: ChatMessage[]
  model?: string
  createdAt: number
  updatedAt: number    // 列表排序依据
}
2. 抽传输层
只暴露两个方法,增量只从 onDelta 出去:
ts
export interface AiChatTransport {
  listModels(): Promise<AiModel[]>
  /** 完成后 resolve;被 abort 时应当尽快结束 */
  chat(req: AiChatRequest, handlers: AiChatHandlers): Promise<void>
}

export interface AiChatRequest {
  model: string
  messages: { role: ChatRole; content: string }[]  // 只传纯文本历史
  files?: ChatAttachment[]                          // 附件单独走,不塞进 JSON
  locale?: string                                   // 界面语言,后端可据此决定语种
  signal?: AbortSignal
}

export interface AiChatHandlers {
  onDelta(chunk: string): void
  onError?(err: unknown): void
}
本地模拟实现只有一件事:把一段固定 markdown 按 6 个字符一片吐出来,两片之间 setTimeout(24ms)。注意它的等待是可中断的 —— abort 后立即 resolve,否则点了停止还要等完当前这一片,手感就是「停止按钮慢半拍」。
全局装配点:
ts
let transport: AiChatTransport = createMockTransport()

export function configureAiTransport(next: AiChatTransport): void {
  transport = next
}
export function getAiTransport(): AiChatTransport {
  return transport
}
3. 会话状态做成模块级单例
useAiChat.ts 里是模块级 ref + 一个取用入口,不是组件内 ref,也不进 Pinia:
- 入口(顶栏图标)和本体(弹窗)是两个不相干的组件,组件内
ref顶栏拿不到; - 关掉弹窗再打开要保留上下文,实例级状态做不到;
- 这是 UI 状态不是业务数据,进 store 太重。
这跟 useDevicePreference 是同一套路。注意解构是安全的:
ts
const { visible, messages, modelId, canSend, open, send } = useAiChat()
// ref 在模板里自动解包,模板直接写 modelId 即可;
// 单例的引用本身不会变,丢掉的只是 .value 包装,不影响响应式。持久化边界(这块最容易写错):
| 存 | 不存 | 原因 |
|---|---|---|
| 文本、角色、模型、时间 | File 对象 | 刷新后 File 必然失效,历史里只留名字 / 大小用于展示 |
| 附件元信息(name/size/type/url) | pending: true 的半成品 | 刷新后它永远停在「生成中」,而实际不会再有增量 |
| 会话列表、分组、当前会话 id、每个会话的模型 | 模型列表本身 | 列表是服务端数据,应以接口为准 |
存储 key:wb-admin:ai-chat:{userId},未登录落 guest。写入 300ms 防抖,localStorage.setItem 外面包 try/catch —— 隐私模式、配额满都会抛,历史丢了不影响继续对话,不能让它冒泡把界面打断。
读取必须假定结构未知:带 SCHEMA_VERSION,版本不一致就迁移或丢弃,不拿旧结构硬解析。
3.1 会话与分组的数据结构
v2 的存储形态(一个 localStorage key 装下某个人的全部会话):
json
{
  "v": 2,
  "activeId": "ls3k-9f2",
  "model": "gpt-4o",
  "groups": [{ "id": "g1", "name": "需求整理", "collapsed": false, "createdAt": 1729400000000 }],
  "sessions": [
    {
      "id": "ls3k-9f2",
      "title": "登录报 403 怎么排查",
      "groupId": "g1",
      "model": "qwen-max",
      "createdAt": 1729400000000,
      "updatedAt": 1729400600000,
      "messages": [{ "id": "m1", "role": "user", "content": "…", "time": 1729400000000 }]
    }
  ]
}| 字段 | 说明 |
|---|---|
sessions[].groupId | '' = 未分组。未分组不是一条 group 记录,省掉「默认分组」初始化与迁移 |
sessions[].title | 首条用户消息截 20 字;空串表示新对话,界面显示「新对话」 |
sessions[].updatedAt | 列表排序依据。只在发送时更新,切换会话不改,否则点一下列表就乱序 |
groups[].collapsed | 折叠状态跟着数据走,刷新后保持 |
三条容易写错的约定:
- 只有一个数据源。
messages是computed(() => sessions[activeId].messages),不是另一份ref。所有写入走updateSession(id, fn);数组里的对象原地改不会触发依赖它的 computed(表现是「点了没反应」)。 - 按会话 id 写回,不认「当前会话」。
send()进来就把sid固定住,流式回调往这个sid追加,所以生成中切到别的会话,回答仍然落回原来那条;sending也是按sid判断,新会话不会错误地显示「停止」。 - 删除分组不删会话。 组内会话
groupId置空回到未分组;读取时若groupId指向已不存在的分组,也自动落回未分组,避免出现谁也看不见的孤儿会话。 - 新会话一律落在未分组,绝不继承当前会话的分组。 这条踩过一次:最初的实现是「在哪个组里点新建就留在哪个组」,想着贴近意图,实际用起来很别扭 —— 手动把几条对话归完之后,接下来新建的全自动钻进那个组,还得再手动挪出来。归组是明确动作,只由「移动到分组」触发。唯一例外是当前会话本来就是空的(还没发过消息),此时「新建」复用这一条并把它移回未分组 —— 空会话本来就不该占着分组。
落盘时机:结构类操作(新建 / 移动 / 改名 / 建组 / 折叠)走 persistNow() 同步写;只有流式增量走 300ms 防抖。这不是性能取舍,是正确性:防抖没触发就刷新,分组归属会静默丢回未分组,界面看起来像「组里的对话自己跑出来了」。另外注册了 pagehide / beforeunload / visibilitychange(hidden) 兜底,把防抖里挂着的那次写掉。
v1 → v2 迁移:老版本只有 {v:1, model, messages}。读到它就包成一条会话(标题取首条消息)放进未分组。少了这一步,用户升级后会看到一个空面板,以为记录全丢了。
4. 弹窗组件
结构分三块(el-dialog 的 header / body / footer):
- header:标题 + 当前模型 tag + 会话栏开关 / 新建对话 / 全屏 / 清空当前对话 / 关闭;
- body:左侧
.wb-ai__side(新建对话、分组与会话列表、新建分组)+ 右侧.wb-ai__chat(.wb-ai__scroll:空态建议问题或消息列表); - footer:拖动条 → 错误条 → 待发附件 → 输入框 → 底栏(左下添加文件,右下模型 + 发送/停止)。
几个实现要点:
ts
// Markdown 渲染:md-editor-v3 体积不小,异步加载 —— 只有开过面板的人才下载这份 chunk
const MdPreview = defineAsyncComponent({
  loader: async () => {
    const mod = await import('md-editor-v3')
    await import('md-editor-v3/lib/style.css')
    return mod.MdPreview
  },
  // 加载失败降级成纯文本:宁可排版差,也不能让整条回复变空白
  errorComponent: PlainTextFallback
})
ts
/*
 * 输入法回车守卫。只判断 e.isComposing 是不够的 —— 上屏时的事件顺序各浏览器不同:
 * Safari 与部分第三方输入法是 compositionend → keydown(Enter, isComposing=false),
 * 于是「按回车确认候选词」会被当成发送(表现:打两个字就自动发出一条)。
 */
const IME_GUARD_MS = 100
let composing = false
let composeEndedAt = 0

function onCompositionStart(): void {
  composing = true
}
function onCompositionEnd(): void {
  composing = false
  composeEndedAt = Date.now()
}

function onEnter(e: KeyboardEvent): void {
  if (e.shiftKey || e.ctrlKey || e.metaKey || e.altKey) return

  const imePending =
    composing ||
    e.isComposing ||
    e.keyCode === 229 || // IME 正在处理的按键,部分输入法不标记 isComposing
    (composeEndedAt > 0 && Date.now() - composeEndedAt < IME_GUARD_MS)

  if (imePending) {
    // 只吞紧跟在上屏之后的那一次,否则「上屏完立刻回车发送」要按两次
    if (!composing && !e.isComposing && e.keyCode !== 229) composeEndedAt = 0
    return
  }

  e.preventDefault()
  void send()
}
模板上要挂 @keydown="onEnter"、@compositionstart="onCompositionStart"、@compositionend="onCompositionEnd"。el-input 内部是 mergeProps(attrs, { onCompositionstart: 自己的 }),两者会合并成数组、不会互相覆盖,所以不需要绕到原生 addEventListener。
为什么必须用时间窗:compositionend 之后紧跟的那次 keydown,浏览器给的 isComposing 是 false(组合已经结束了),但它是同一发回车、不是用户新按的。除了时间窗没有可靠的同步判据,keyCode === 229 只能补一部分输入法。
写测试时注意:派发合成的 KeyboardEvent 测不出这个 bug,因为 isComposing 由浏览器在真实组合状态下填充。要用 CDP 制造真实时序:
ts
const cdp = await page.context().newCDPSession(page)
await cdp.send('Input.imeSetComposition', { text: 'nihao', selectionStart: 5, selectionEnd: 5 })
await cdp.send('Input.insertText', { text: '你好' }) // 上屏 = compositionend
await cdp.send('Input.dispatchKeyEvent', { type: 'keyDown', key: 'Enter', code: 'Enter', windowsVirtualKeyCode: 13 })输入框高度自己管,不用 el-input 的 autosize:autosize 会把高度算成内联样式,且只在 autosize 为真时重算;一旦拖动改高度,那份内联 height 会一直压着你,CSS 变量和 !important 都抢不过。现在的做法是:
- 自动模式:先
height:auto,再读scrollHeight + 边框,钳到[2 行, 6 行]; - 拖动后:固定像素,内容再多只在框内滚动;
- 双击拖动条 / 拖回到下限以下:回到自动增高;
- 上限两条约束取小:① 输入框底边 → 弹窗顶边留 170px(否则对话区被挤没);② 窗口模式下「视口高 − 弹窗高 − 24」。全屏时高度增长由对话区吸收,不适用 ②。
5. 接入入口
vue
<!-- Navbar -->
<el-icon class="wb-icon-btn wb-ai-entry" data-test="ai-entry" @click="aiChat.open()">
  <MagicStick />
</el-icon>
ts
// layouts/index.vue
if ((e.ctrlKey || e.metaKey) && e.key.toLowerCase() === 'i') {
  // 在输入框里按 Ctrl+I 是「斜体」的地盘,别抢
  const el = e.target as HTMLElement | null
  if (el && (el.tagName === 'INPUT' || el.tagName === 'TEXTAREA' || el.isContentEditable)) return
  e.preventDefault()
  aiChat.toggle()
}
6. 国际化
文案全部走 ai.*(src/locales/lang/zh-CN.ts / en-US.ts):title、placeholder、send、stop、clear、clearConfirm、addFile、fileHint、fileRejected、model、emptyTitle、emptyDesc、suggest1~3、copy、failed、resizeHint。加语言时两边都要补,缺 key 会直接显示 key 本身。
二、前后端如何对接
方式 A:换成内置 HTTP transport(先试这个)
ts
// src/main.ts,放在 app.mount 之前即可
import { configureAiTransport, createHttpTransport } from '@/composables'

configureAiTransport(
  createHttpTransport({
    // 默认取 import.meta.env.VITE_API_PREFIX(dev=/api,prod=/prod-api)
    baseURL: import.meta.env.VITE_API_PREFIX ?? '/api',
    modelsPath: '/ai/models',
    chatPath: '/ai/chat'
  })
)
接口路径跟你的后端不一致时,只改这两个 path,不要复制一份 transport 出来改。
方式 B:完全自定义 transport
网关吐的格式比较特别、或者你直接用厂商 SDK / WebSocket 时,实现接口即可:
ts
import { configureAiTransport, type AiChatTransport } from '@/composables'

const myTransport: AiChatTransport = {
  async listModels() {
    const res = await myApi.models()
    return res.map((m) => ({ id: m.model_id, name: m.display_name, provider: m.vendor }))
  },
  async chat(req, { onDelta }) {
    // 关键三点:1) 透传 req.signal,让「停止」真正断流;
    //          2) 增量只通过 onDelta 吐出;
    //          3) 正常结束就 resolve,不要为了「结束」抛错。
    const stream = await sdk.chat.stream(
      { model: req.model, messages: req.messages, files: req.files?.map((f) => f.file) },
      { signal: req.signal }
    )
    for await (const evt of stream) {
      if (req.signal?.aborted) return
      if (evt.delta) onDelta(evt.delta)
    }
  }
}

configureAiTransport(myTransport)
方式 C:只替换一半
ts
const mock = createMockTransport()
configureAiTransport({
  listModels: async () => (await fetch('/api/ai/models').then((r) => r.json())).data,
  chat: mock.chat.bind(mock) // 回答仍用模拟,先把模型列表对接起来
})
鉴权与请求头
HTTP transport 走的是原生 fetch,不经过 utils/request.ts 的 axios 拦截器,所以请求头是单独拼的(authHeaders()),目前带三个,与主请求层同名同值:
| Header | 来源 | 缺失后果 |
|---|---|---|
Authorization: Bearer <token> | getToken() | 401 |
X-Tenant-Id | getTenantId() | 多租户后端按「无租户」处理:403 或读到别的租户数据 |
Accept-Language | localStorage['wb-admin-locale'] | 后端无法按界面语言回话 |
加自定义头(
X-Trace-Id、X-Client-Version等)改transport.ts的authHeaders()一处即可。 若后端用 Cookie 鉴权,需要credentials: 'include',这两处fetch都要加。 另外记住:fetch不会像 axios 那样自动重试 / 弹全局错误提示,失败提示在面板里由lastError呈现。
三、后端应该提供什么
接口 1:GET /ai/models
返回当前用户可用的模型清单(按权限 / 租户套餐过滤,不要返回全量)。
json
{
  "code": 200,
  "msg": "ok",
  "data": [
    { "id": "gpt-4o", "name": "GPT-4o", "provider": "OpenAI", "context": 128000, "desc": "通用能力最强" },
    { "id": "qwen-max", "name": "通义千问 Max", "provider": "阿里云", "context": 32000 }
  ]
}| 字段 | 必填 | 说明 |
|---|---|---|
id | ✅ | 对话接口里回传的模型标识,必须与 POST /ai/chat 的 model 对得上 |
name | ✅ | 下拉框显示名 |
provider | — | 下拉项右侧灰字 |
context | — | 上下文窗口,界面暂未展示,留作后续提示 |
desc | — | 备注 |
disabled | — | true 时选项可见但不可选(下线过渡期用) |
code 不是 200 / 0 时,前端会抛错并显示 msg。
接口 2:POST /ai/chat
Content-Type: multipart/form-data(有附件时必须走 multipart,前端就是这么发的)。
| 字段 | 类型 | 必填 | 说明 |
|---|---|---|---|
model | text | ✅ | 模型 id。前端在列表未返回时会兜一个默认值,后端仍要校验白名单 |
messages | text | ✅ | JSON 字符串,[{role, content}],按时间正序,最后一条是本次输入;附件不在里面 |
locale | text | — | zh-CN / en-US,决定回复语种 |
files | file(可重复) | — | 本次新上传的附件,最多 5 个、单个 ≤ 10MB |
fileUrls | text(可重复) | — | 历史里已上传过的附件地址(刷新后重发时用) |
messages是字符串不是 JSON 对象 —— multipart 里没法嵌对象,后端拿到后需要JSON.parse。解析失败请直接回 400,别当空历史处理。
响应 A:SSE 流式(推荐)
http
HTTP/1.1 200 OK
Content-Type: text/event-stream; charset=utf-8
Cache-Control: no-cache, no-transform
Connection: keep-alive
X-Accel-Buffering: no
data: {"choices":[{"delta":{"content":"我按"}}]}
data: {"choices":[{"delta":{"content":"三步拆"}}]}
data: [DONE]前端解析器兼容这几种载荷,后端挑一种稳定输出即可:
- OpenAI 风格:
{"choices":[{"delta":{"content":"…"}}]} - 简化对象:
{"content":"…"} - 包一层:
{"data":{"content":"…"}} - 裸文本:
data: 你好(非 JSON 时按纯文本处理)
规则:按空行(\n\n)分块、逐行取 data: 之后的内容、遇到 [DONE] 或空载荷跳过。增量按 TextDecoder(..., { stream: true }) 解码 —— 一个汉字 3 字节,很可能被 TCP 切成两半,用普通 decode 会出现乱码。
响应 B:普通 JSON(不流式)
json
{ "code": 200, "msg": "ok", "data": { "content": "完整回复文本" } }data 直接是字符串也兼容。前端会自动降级为一次性输出,只是没有打字机效果 —— 联调阶段先用这个,跑通再改 SSE。
服务端职责清单
| 职责 | 具体要求 | 不做的后果 |
|---|---|---|
| 鉴权 | 校验 token,从 token 里取 userId,不要信前端传的用户 id | 越权调用、账单算到别人头上 |
| 租户隔离 | 读 X-Tenant-Id,校验该用户属于该租户;模型白名单、配额按租户算 | 跨租户数据泄露 |
| 限流 | 按 userId + 时间窗(如 20 次/分钟),超限回 429 | 一个脚本把额度刷完 |
| 文件校验 | 后端再校验类型、数量(≤5)、体积(≤10MB);不要信 accept | 前端限制只是体验,绕过去很容易 |
| 文件处理 | 图片走多模态 / OCR,文档抽文本后截断再拼进 prompt;落对象存储并回写 url | 直接把二进制塞给模型,必然失败 |
| 历史裁剪 | 按模型上下文窗口截断(保留 system + 最近 N 轮) | 超长报错,或者账单暴涨 |
| 断连中止 | 监听 req.on('close') → abort 上游请求 | 用户点了停止,token 还在继续烧 |
| 审计 | 记录 userId、model、耗时、token 数、附件数、是否中止 | 出问题无法复盘,也没法做用量统计 |
| 超时 | 首字节超时 + 总时长上限(如 120s) | 连接挂死,前端一直转圈 |
错误约定
前端对失败的呈现就一条:气泡标红 + composer 上方显示一行错误文案。所以:
| 场景 | 建议返回 | 前端表现 |
|---|---|---|
参数不对 / messages 解析失败 | 400 + {code:400,msg:'messages 格式错误'} | 红字显示 HTTP 400(当前实现只取状态码) |
| 未登录 / token 过期 | 401 | 红字 HTTP 401,需要自行接登录续期 |
| 无权限 / 额度不足 | 403 + {code:403,msg:'本月额度已用完'} | 红字 HTTP 403 |
| 流式中途出错 | 先发一条错误事件再断开(见下) | 保留已生成内容,气泡标红 |
createHttpTransport 会校验响应体里的 code(200 / 0 为成功),业务错误即使 HTTP 200 也会被判失败 —— 否则界面会「回复了但一个字都没有」,比报错更难查。建议同时用正确的 HTTP 状态码,因为流式请求一旦发出 200 就无法再改。
流中途异常的两种选择:
ts
// 1) 直接断开连接:前端 reader.read() 抛错 → 气泡标红,保留已生成内容
res.destroy()
// 2) 先把错误当成一段文本吐出去,再正常结束(用户能看到原因,但不标红)
res.write(`data: ${JSON.stringify({ content: '\n\n> 生成中断:上游超时' })}\n\n`)
res.write('data: [DONE]\n\n')
res.end()
最小可运行后端(Node + Express)
auth / listModelsFor / callModel 是占位,按你自己的鉴权中间件与模型 SDK 实现;重点是头部与生命周期这几行。
ts
import express from 'express'
import multer from 'multer'

const app = express()
const upload = multer({ storage: multer.memoryStorage(), limits: { fileSize: 10 * 1024 * 1024 } })

app.get('/api/ai/models', auth, (req, res) => {
  res.json({ code: 200, msg: 'ok', data: listModelsFor(req.user) })
})

app.post('/api/ai/chat', auth, upload.array('files', 5), async (req, res) => {
  const model = String(req.body.model || '')
  if (!isModelAllowed(req.tenant, model)) {
    return res.status(403).json({ code: 403, msg: '模型不可用' })
  }
  let messages
  try {
    messages = JSON.parse(req.body.messages || '[]')
  } catch {
    return res.status(400).json({ code: 400, msg: 'messages 格式错误' })
  }

  // SSE 头:no-transform + X-Accel-Buffering 一起用,防止 Nginx / CDN 缓冲住整段
  res.writeHead(200, {
    'Content-Type': 'text/event-stream; charset=utf-8',
    'Cache-Control': 'no-cache, no-transform',
    Connection: 'keep-alive',
    'X-Accel-Buffering': 'no'
  })
  res.flushHeaders?.()

  const controller = new AbortController()
  req.on('close', () => controller.abort()) // 用户点「停止」→ 立刻掐上游,别再烧 token

  try {
    const answer = await callModel({ model, messages, files: req.files, signal: controller.signal })
    for await (const delta of answer) {
      if (controller.signal.aborted) return
      res.write(`data: ${JSON.stringify({ choices: [{ delta: { content: delta } }] })}\n\n`)
    }
    res.write('data: [DONE]\n\n')
    res.end()
  } catch (e) {
    if (!controller.signal.aborted) res.write(`data: ${JSON.stringify({ content: '\n\n> 生成失败,请重试' })}\n\n`)
    res.end()
  }
})
反向代理要放开缓冲
Nginx 默认会缓冲上游响应,SSE 就变成「等全部生成完才一次性出现」,看起来像没做流式:
nginx
location /prod-api/ai/ {
  proxy_pass http://backend;
  proxy_http_version 1.1;
  proxy_set_header Connection '';
  proxy_buffering off;          # 关键
  proxy_cache off;
  proxy_read_timeout 300s;      # 长回答别被 60s 默认值掐断
  chunked_transfer_encoding off;
}
四、具体用法
用户操作
| 操作 | 行为 |
|---|---|
顶栏 ✨ / Ctrl + I | 打开或关闭面板(焦点在输入框内时不响应,避免抢斜体快捷键) |
| 标题栏第一个图标 | 展开 / 收起左侧会话栏;窄屏(≤900px)下是浮层,默认收起 |
标题栏 + / 侧栏「新建对话」 | 新建对话,一律落在「未分组」(不继承当前会话的分组);当前会话本来就是空的则复用那一条并移出分组 |
| 会话项 | 点击切换;悬停出 ⋯:重命名 / 移动到某个分组 / 删除对话 |
| 分组标题 | 点击折叠展开并持久化;悬停 ⋯:重命名分组 / 删除分组(组内对话回落到未分组) |
| 侧栏底部「新建分组」 | 输入名称建组;重名直接复用已有分组 |
Enter | 发送。输入法组合中、上屏那一下(100ms 内)、按住 Shift / Ctrl / Alt 时都不发送 |
Shift + Enter | 换行 |
| 左下「添加文件」 | 选文件(图片、pdf、txt、md、json、csv、xlsx、docx、pptx、zip),单文件 ≤ 10MB,最多 5 个;超限的会被忽略并提示 |
| 右下模型下拉 | 切换模型,只影响之后的发送;选择会记在当前会话上,切回来仍是它 |
| 右下「发送 / 停止」 | 生成中按钮变「停止」,点它是中断而非失败,已生成的半截内容会保留 |
| 输入区上沿拖动条 | 上下拖动改输入框高度;双击复位为「跟随内容自动增高」;聚焦后 ↑ / ↓ 各调 16px |
| 全屏 | 对话区吃掉整屏高度,输入区贴底 |
| 清空 | 二次确认后清空当前这条对话(不动其他会话与分组) |
| 消息右下复制图标 | 复制该条正文(markdown 原文) |
| 生成中关闭面板 / 切换会话 | 不中断,消息继续在后台拼装;切回来能看到完整结果 |
编程式调用
ts
import { useAiChat } from '@/composables'| 成员 | 类型 | 说明 |
|---|---|---|
visible | Ref<boolean> | 面板显隐(也可直接 v-model 到自己的按钮) |
messages | ComputedRef<ChatMessage[]> | 当前会话的消息(派生自 sessions,只读) |
models / modelId | Ref<AiModel[]> / Ref<string> | 模型列表与当前选择 |
draft | Ref<string> | 输入框内容 |
attachments | Ref<ChatAttachment[]> | 待发送附件 |
sending | ComputedRef<boolean> | 当前会话是否生成中(别的会话在后台生成不算) |
lastError | Ref<string> | 最近一次失败原因,清空即隐藏错误条 |
canSend | ComputedRef<boolean> | 有内容或附件、且当前会话不在生成中 |
sessions | ComputedRef<ChatSession[]> | 全部会话,按 updatedAt 倒序 |
groups | Ref<ChatGroup[]> | 分组列表(按创建顺序) |
activeId / activeSession | Ref<string> / ComputedRef<ChatSession | undefined> | 当前会话 id 与对象 |
groupedSessions | ComputedRef<SessionBucket[]> | 侧栏渲染数据:未分组置顶 + 各分组(空分组也保留) |
open() / close() / toggle() | () => void | 显隐控制,open() 会按当前登录人载入历史并拉模型列表 |
send() / stop() / clear() | — | 发送 / 中断当前会话 / 清空当前会话 |
addFiles(files) | (files: File[]) => { added, skipped } | 手动添加附件,返回被拒文件名 |
removeAttachment(uid) | (uid: string) => void | 移除待发附件 |
createSession(groupId?) | (groupId?: string) => void | 新建并切换;当前会话本来就是空的则复用 |
switchSession(id) | (id: string) => void | 切换会话(会清空草稿与待发附件,避免发错会话) |
renameSession(id, title) | — | 手动改名,之后不再自动生成标题 |
removeSession(id) | — | 删除;删的是当前会话时自动切到最近一条 |
moveSession(id, groupId) | — | 移到分组,groupId: '' 即未分组 |
createGroup(name) / renameGroup(id, name) / removeGroup(id) / toggleGroup(id) | — | 分组增删改与折叠,createGroup 重名时返回已有 id |
reload() | () => void | 按当前登录人重新载入历史 |
场景 1:列表页「带着上下文去问」
ts
const chat = useAiChat()

function askAbout(row: { name: string; error: string }) {
  chat.draft.value = `这个任务报错了,帮我分析原因:\n\n任务:${row.name}\n报错:${row.error}`
  chat.open() // open 之后输入框自动聚焦,用户直接回车即可
}
场景 2:不想放在顶栏,只留一个悬浮按钮
弹窗本体只在 layouts/index.vue 挂了一次,删掉 Navbar 里那个图标即可,useAiChat().open() 可以在任意地方调用。若要做成纯浮层(不遮挡页面),直接给 visible 绑自己的 el-drawer,消息列表与 composer 都能复用。
场景 3:切换账号
ts
import { switchAiChatUser } from '@/composables'

// 登录成功后
switchAiChatUser(userStore.userId)
// 登出时
switchAiChatUser('guest')
历史按 userId 分桶,不切换会看到上一个人的对话。open() 内部也会比对当前 userId,不一致才重载,所以只要登录流程更新了 userStore.userId,即使忘了调用也不会串号。
场景 4:按业务模块归档对话
ts
const chat = useAiChat()

function askAboutTicket(row: { id: string; title: string }) {
  // 分组不存在就建(createGroup 重名时返回已有 id,不会产生两个同名分组)
  const groupId = chat.createGroup('工单排查') as string
  chat.createSession(groupId) // 新对话直接落在该分组下
  chat.draft.value = `工单 #${row.id}:${row.title}\n帮我判断可能的原因`
  chat.open()
}
五、常量与配置
| 位置 | 常量 | 默认 | 说明 |
|---|---|---|---|
transport.ts | MAX_FILE_SIZE_MB | 10 | 单文件上限,前端校验;后端必须再校验一次 |
transport.ts | DEFAULT_MODELS | 5 个 | 模型接口不可用时的兜底清单(只用于占位,不代表真实可用) |
useAiChat.ts | MAX_FILES | 5 | 单次最多附件数 |
useAiChat.ts | HISTORY_LIMIT | 100 | 每个会话保留的消息条数 |
useAiChat.ts | SESSION_LIMIT | 30 | 最多保留的会话数,按最近使用截断 |
useAiChat.ts | TITLE_LIMIT | 20 | 自动标题的字符数上限 |
useAiChat.ts | SAVE_DEBOUNCE | 300 | 落盘防抖(ms) |
useAiChat.ts | SCHEMA_VERSION | 2 | 存储结构版本;改结构时 +1(v1 单会话数据会被迁移成一条会话) |
useAiChat.ts | STORAGE_KEY_PREFIX | wb-admin:ai-chat | 实际 key 为 …:{userId} |
index.vue | ACCEPT | 见源码 | 文件选择器的类型白名单,纯体验层限制 |
index.vue | sideOpen 初值 | innerWidth > 900 | 窄屏默认收起会话栏 |
改 MAX_FILES / MAX_FILE_SIZE_MB 后,提示文案里的数字会自动跟着变(走 i18n 插值),但要同步告诉后端。
六、常见坑
- 打包部署后点发送就 404。 默认的
createHttpTransport()会请求/ai/chat,而仓库的 mock 中间件只在 dev server 里存在,静态产物里一个请求都发不出去。所以默认 transport 是浏览器内模拟 —— 这也是为什么这个面板在 GitHub Pages 上能直接演示。要接真后端,别忘了一起配baseURL与代理。 el-input的autosize会和拖动改高度打架。 它把高度写成内联样式且只在 autosize 为真时重算,关掉之后那份height/min-height仍留在元素上(实测拖到 138px,元素死守 58px),CSS 变量与!important都没用。现在高度全部自己算。<style scoped>管不到el-dialog的根元素。el-dialog的根是Teleport,class="wb-ai"挂上去了,data-v-*没挂上去 —— 所有.wb-ai[data-v-x] …规则静默失效(不报错、控制台干净)。这类「dialog 自己」的规则一律写:global(),且不能嵌在.wb-ai { }里,否则会被拼成.wb-ai[data-v-x] .wb-ai.is-fullscreen。判据:el.matches('.wb-ai[data-v-x]')为false就说明整段没生效。- e2e 里
[data-test=ai-input] textarea选不到东西。el-input会把data-test透到内层textarea上,带这个属性的就是 textarea 自己,它里面没有 textarea。直接[data-test=ai-input]即可。 - 模型列表还没回来就发送 →
model为空 → 后端 400。 现在useAiChat()先填DEFAULT_MODELS[0]占位,send()里再兜一层modelId || models[0]?.id。后端仍要校验,不要假设前端一定传对。 - 流式半成品不能落盘。 刷新后拿到的
pending消息永远停在「生成中」,因为增量早就没了。 - 汉字会被切两半。 SSE 必须用
TextDecoder(..., { stream: true })增量解码,并按\n\n缓冲后再切行;直接对每个 chunk 调decode()会出现乱码。 - dev 的 mock 接口只解析 JSON。
POST /ai/chat是 multipart,mock 中间件会把请求体读成原始字符串(JSON.parse失败就返回字符串),于是messages为空、只能回「(空)」。联调 multipart 请连真实后端,或先给 mock 补一个 multipart 解析器。 - 附件回放只有元信息。 历史里的附件不带
File,重发时传的是fileUrls(若后端当时回写了 url),否则只能展示「发过什么」。 - 失败没有全局提示。
fetch不经过 axios 拦截器,401 不会触发登录续期,错误只体现在面板里的红字。生产环境建议在 transport 里统一处理 401 跳登录。 - 整对象落盘会把
File写成{}。 单会话时是手工挑字段,所以没暴露;改多会话后如果直接JSON.stringify(session),File会变成空对象存进去 —— 读回来attachments[0].file存在但不是 File,fetch(file)之类操作才炸,而且已经写进历史。落盘前必须逐字段重建消息。(这条是单测先抓到的。) messages不能既当数据源又当镜像。 多会话下若保留一个messagesref 再手动同步 sessions,总有一次忘记同步:典型症状是「切回去少一条」或「增量写到别的会话」。现在它是computed(() => sessions[activeId].messages),唯一写入口是updateSession()。- e2e 别按位置点顶栏图标。 加了「会话栏 / 新建对话」两个图标后,原来的
.wb-ai__act第 1 个从「全屏」变成了「会话栏」,全屏用例立刻红(宽度 820 vs 820)。所有可点图标都补了data-test,按语义选。 - 空会话不进存储。 否则每点一次「新建对话」就多一条空记录,30 条之后真正有用的会话会被
SESSION_LIMIT挤掉;当前会话除外,否则刷新后activeId指向一条不存在的会话。 e.isComposing拦不住「上屏那一下的回车」。 浏览器/输入法的顺序并不统一,Safari 与部分第三方输入法是compositionend先触发、随后的keydown里isComposing已是false,于是确认候选词的回车直接把消息发了出去(用户感受是「打两个字就自动发送」)。必须配合 composition 生命周期 + 上屏后约 100ms 的时间窗(见上文「输入法回车守卫」)。这个 bug 用合成KeyboardEvent测不出来,只能靠 CDP 的真实 IME 时序。- 结构类操作别走防抖落盘。 移动分组、建组、折叠原来和流式增量共用 300ms 防抖,用户「挪完分组马上刷新」就会丢,表现是组里空掉、会话自己跑回未分组 —— 而且下一次操作才把它覆盖掉,事后完全查不出来。低频操作一律
persistNow(),再用pagehide/visibilitychange兜底。 - 「取列表第一条」这种断言会掩盖数据丢失。 侧栏结构是「未分组桶固定在最前」,所以当会话的
groupId意外丢失时,它会掉进未分组、又因为updatedAt最新而排在第一位 —— 断言first() = 某会话反而通过了,看起来一切正常。要按桶断言(.wb-ai__group里再筛),别用全局first()。
七、测试
bash
# 单元测试(传输层、流式、abort、附件、会话与分组、v1 迁移)
npx vitest run test/unit/ai-chat.spec.ts

# 真实浏览器交互(需要先起 dev server)
npx vite --port 3100 --strictPort
E2E_PORT=3100 npx playwright test test/e2e/ai-chat.spec.ts
单测覆盖:模型列表返回副本(防止外部改动污染常量)、流式增量拼成完整消息、abort 后保留已生成内容且不标红、附件超限被拒、历史按 userId 隔离、clear() 后存储同步清空;会话与分组部分覆盖「新建对话互不干扰 + 标题取首条消息 + 排序」「空会话不重复创建」「建组 / 移动 / 改名 / 删组后会话回落未分组」「同名分组复用」「删当前会话自动切下一条」「生成中切走、增量仍写回原会话」「新会话不继承当前分组」「v1 历史迁移成一条会话」。
e2e 覆盖:顶栏图标唤起、发送后收到流式回复且按钮变「停止」、切换模型后消息 meta 显示所选 id、附件随消息发出且待发区清空、拖动输入区上沿可调高度并双击复位、刷新后历史仍在、Enter 发送 / Shift + Enter 只换行、全屏铺满并能复原、新建对话 / 建组 / 移动 / 折叠 / 刷新后分组与会话仍在 / 在分组内点新建仍落在未分组。
新增断言前先确认它能失败(临时撤掉修复再跑一次)。只跑一次绿,永远是假绿。